En bref
- Dates
- –
- Contexte
- Technologies
Présentation
Simulation environnementale et anthropologique en AR, pilotée par Deep Reinforcement Learning (CNN).
Problème
Faire comprendre les conséquences d’un choix d’aménagement (pollution, inondations) avant de construire : une simulation de ville durable pensée pour les études d’urbanisme.
Rôle
Chef de projet d’une équipe de 3.
Décisions
Une IA entraînée par Deep Reinforcement Learning (CNN), avec un apprentissage par étapes ; un moteur de simulation en Python relié en UDP à une application Unity en réalité augmentée.
Résultat
Prototype fonctionnel, essayé par les visiteurs des portes ouvertes de l’ENSIM. Sur 1 000 parties, l’IA obtient un score moyen 4,75 fois supérieur à celui d’une stratégie aléatoire.
Ma contribution
- L’essentiel de l’intelligence artificielle : modélisation du problème, réseau de neurones, stratégie d’entraînement, réglage et évaluation.
- La plus grande part de l’état de l’art : réalité mixte et IA pour la prévention des catastrophes.
- Une participation à la conception des règles, au moteur de simulation en Python et à la gestion de projet.
Cahier des charges
| Exigence | Réponse apportée |
|---|---|
| Une ville à construire | Carte fixe de 15 × 10 tuiles (montagne, forêt, plaine, rivière), deux ressources (bois, pierre) et six bâtiments : scierie, carrière, habitations, centrale à charbon, éolienne, centrale nucléaire. |
| Un score, sans victoire ni défaite | Score final = vertu des constructions − pollution (à la construction, puis dans la durée) − dégâts des inondations. Une partie dure 15 minutes. |
| Deux aléas | Des inondations aléatoires (jusqu’à deux par partie) détruisent les bâtiments voisins des rivières ; la pollution industrielle contamine les tuiles voisines des scieries, carrières et centrales à charbon. |
| Un conseil à la demande | Un bouton « Conseil IA » propose la meilleure action selon les ressources et les tuiles disponibles : construire, détruire ou attendre. |
| Réalité augmentée | La carte apparaît sur une table après le scan d’un QR code ; les bâtiments s’y posent en 3D, avec une prévisualisation avant validation. |
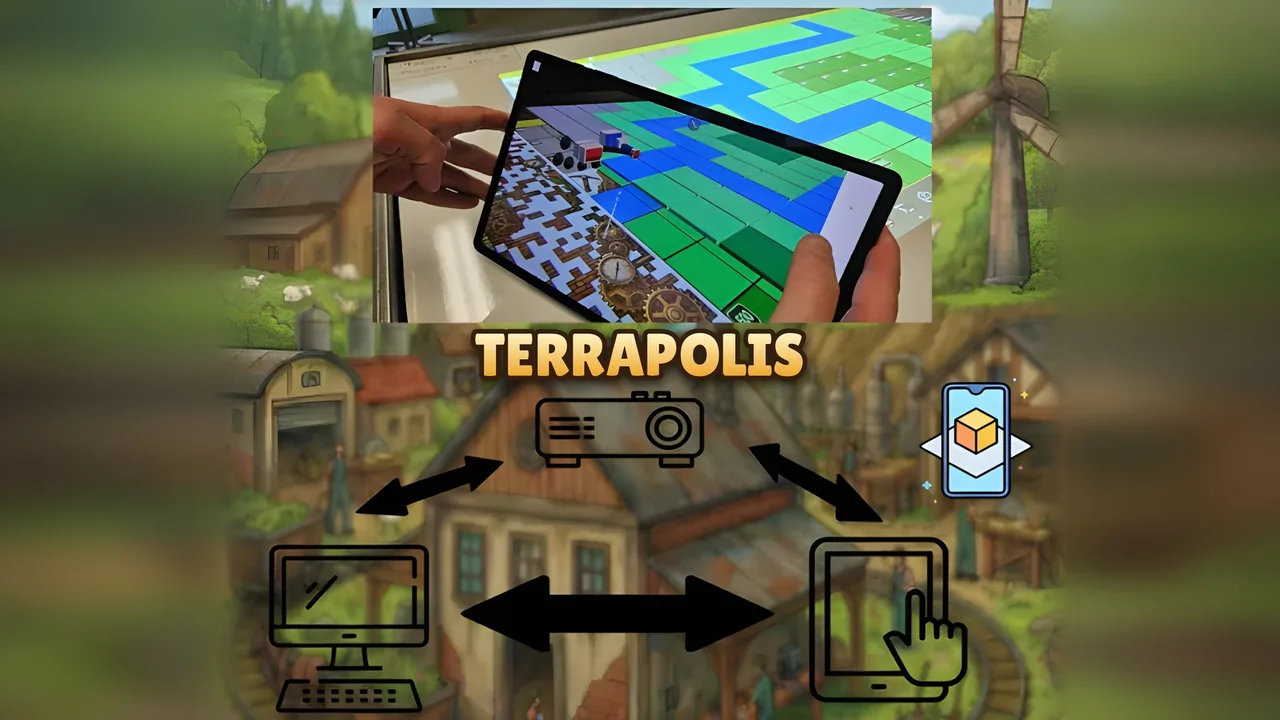
| Deux appareils synchronisés | L’ordinateur calcule (règles et IA en Python), la tablette affiche (application Unity) ; ils échangent en UDP sur le réseau local, au format JSON. |
Fonctionnement
- Tablette ou téléphone Application Unity (AR Foundation) : vue en réalité augmentée, vue 2D, menu des bâtiments.
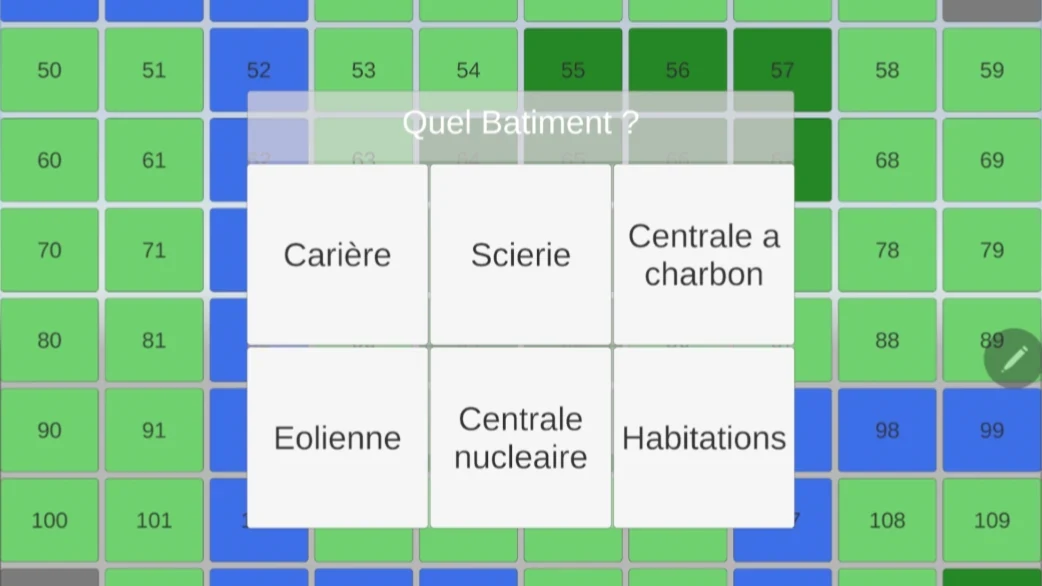
Sur la tablette : la vue 2D et le menu des six bâtiments à poser. - Réseau local UDP, messages JSON : faible latence, carte et actions synchronisées.
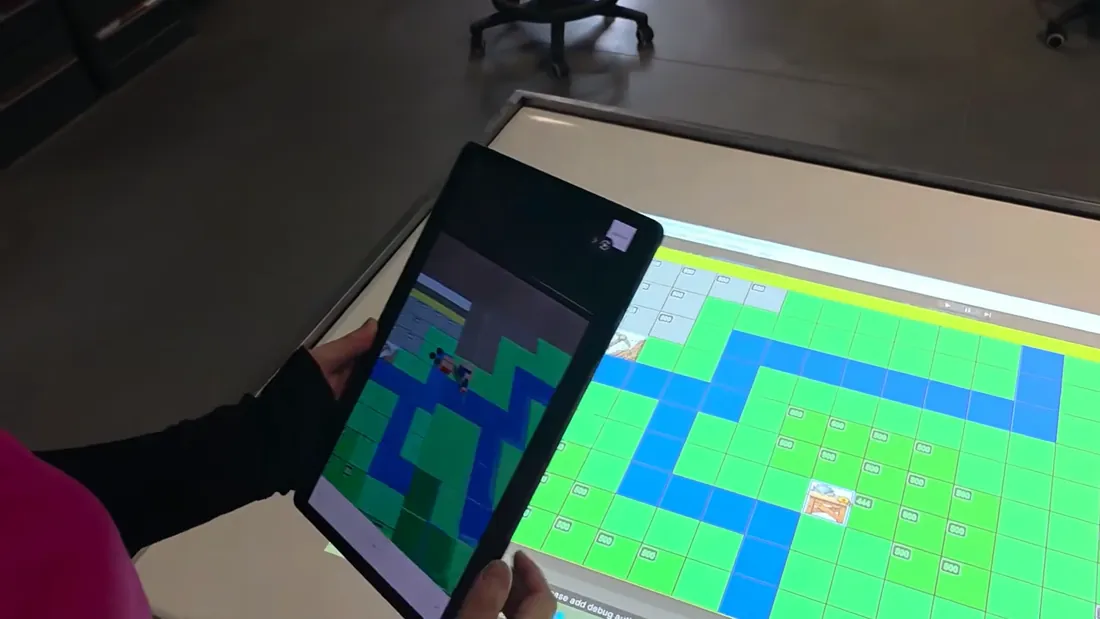
La tablette et la carte projetée montrent le même état, synchronisé par le réseau. - Ordinateur Moteur de simulation et IA en Python : règles, scores, conseil.
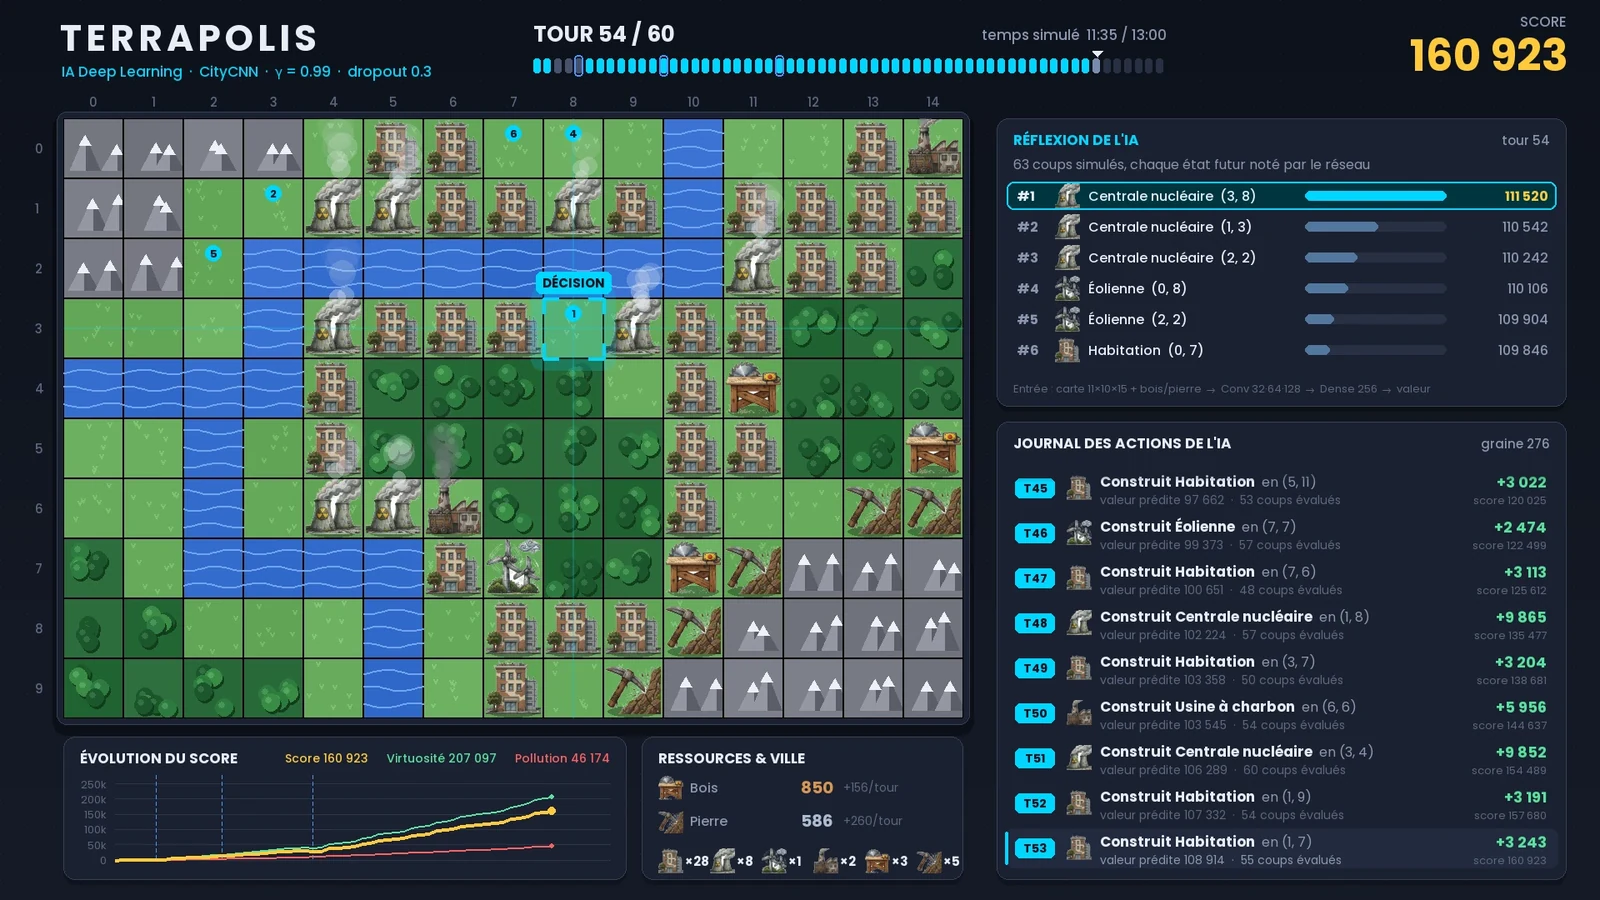
Sur l’ordinateur : la carte, les coups évalués par l’IA à chaque tour et le journal de ses actions. Agrandir l’image
L’intelligence artificielle
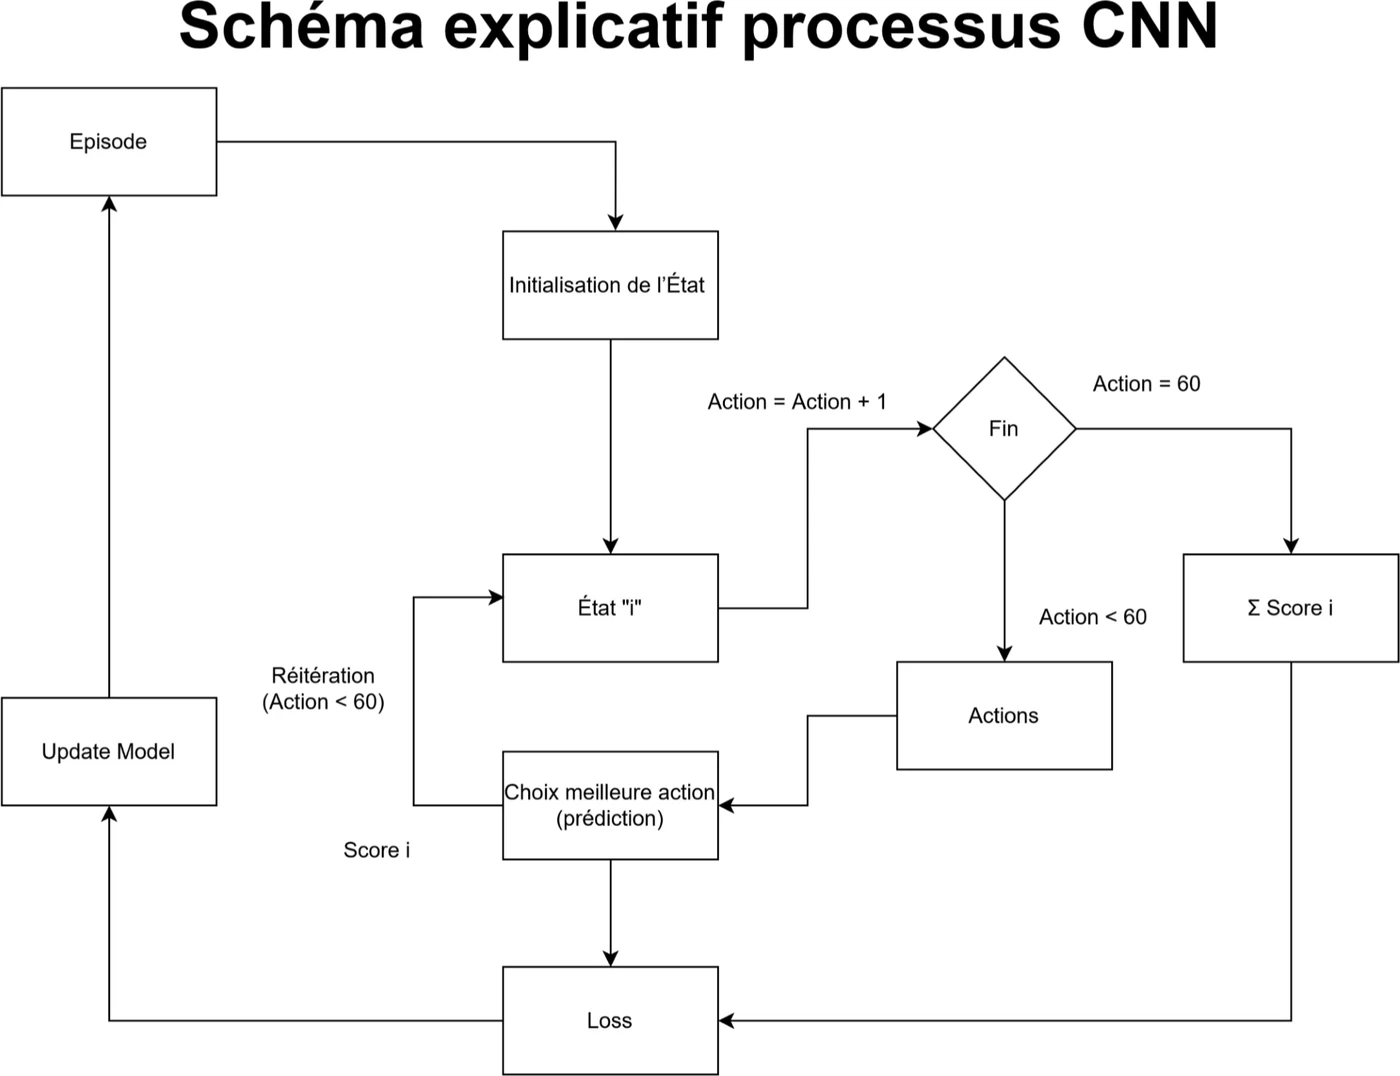
La grille de jeu est traitée comme une image : un réseau de neurones convolutif (CNN) apprend, par renforcement, quelle action rapporte le plus sur la durée d’une partie.
- Entrées : l’état du terrain (une matrice par type de tuile et de bâtiment) et les ressources disponibles. Sortie : la valeur estimée de chaque action.
- Trois couches de convolution (32, 64 puis 128 filtres 3 × 3) qui apprennent le voisinage : bord de rivière, forêt proche, coin de carte…
- Une partie = 60 décisions, une toutes les 15 secondes. L’exploration, forte au début, décroît à chaque épisode au profit des meilleurs coups.
Le déclic : apprendre par étapes. Avec toutes les règles d’emblée, l’IA apprenait surtout à ne rien construire pour ne pas perdre de points. L’entraînement a donc été découpé en trois phases (curriculum learning) :
- Ressources infinies, pollution ignorée, récompense à la construction : apprendre la mécanique.
- Retour de la pollution, ressources toujours infinies : apprendre qu’un mauvais emplacement coûte cher dans la durée.
- Ressources remises à zéro et exploration décroissante : exploiter les meilleurs comportements.
Résultats
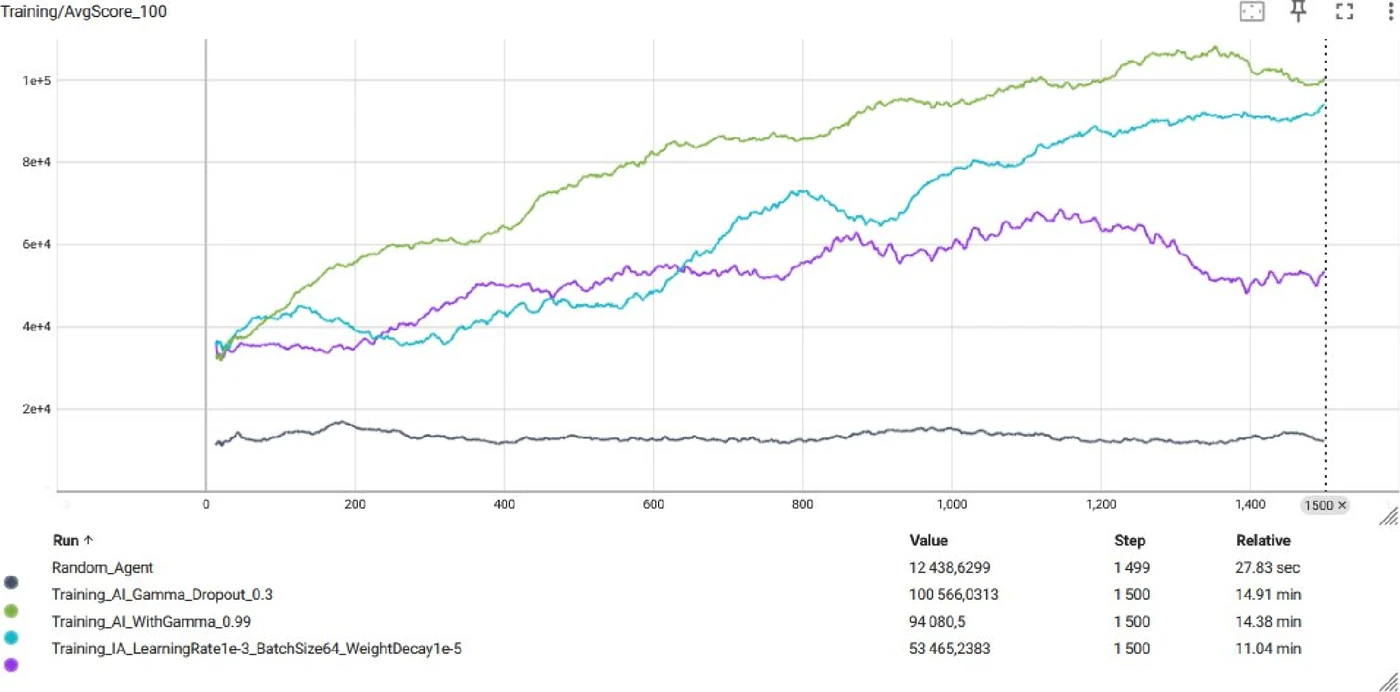
- score moyen de l’IA face à une stratégie aléatoire, sur 1 000 parties
- × 4,75
- score moyen de l’IA (12 940 au hasard)
- 61 428
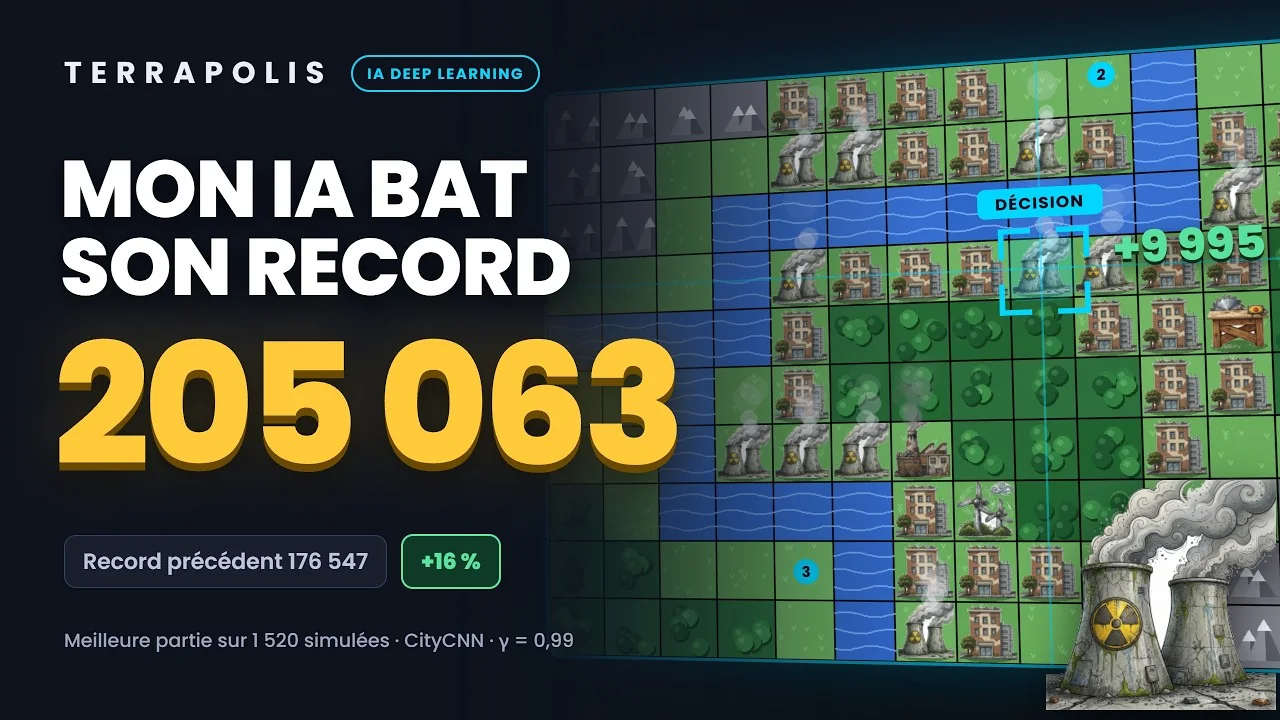
- record de l’IA : sa meilleure partie sur 1 520 simulées (meilleur score du hasard : 54 685)
- 205 063
- épisodes pour l’entraînement final
- 1 500
Une partie moyenne de l’IA (61 428) dépasse la meilleure partie obtenue au hasard (54 685). Le prototype, fonctionnel, a été essayé par les visiteurs des portes ouvertes de l’ENSIM.
- Stratégie aléatoire
- IA entraînée
| Scores | Stratégie aléatoire | IA entraînée |
|---|---|---|
| Pire score | −20 174 | −3 639 |
| Score moyen | 12 940 | 61 428 |
| Meilleur score | 54 685 | 205 063 |
Pire score et score moyen : 1 000 parties de test. Meilleur score de l’IA : sa meilleure partie sur 1 520 simulées.